日常開發與文字先選 GPT-6.1 Sol;長程程式 agent 看 Claude Opus 5.5;難推理再升級 Astra 或 Fable。 Google 的影音文件工作流看 Gemini 4 Argon;大量分類、抽取則用 Luna、Haiku 或 Flash-Lite。下面用能力數據與價格說明為什麼。
先看用途與升級路徑
圖中往右(手機上往下)是工作變難時的升級方向,不表示 Gemini、Terra 或小模型排在後面就比較弱。 影音輸入、畫面操作、大量簡單請求,本來就有不同的選法。要比較綜合能力與成本,請看下方使用同一份評測口徑的數據圖。
直接照用途選
| 你現在要做什麼 | 我會先選 | 什麼時候換更高階或不同類型 |
|---|---|---|
| 日常寫功能、改文案、整理資料,不想每次都開最貴模型 | GPT-6.1 Sol | 多個限制互相牽制,或需要更深的推理時,換 Astra |
| 在 Claude 系統裡做一般開發與反覆修改 | Claude Sonnet 5.5 | 長程 agent、較難的跨檔案工作,換 Opus 5.5 |
| agent 要連續操作 repo、終端機並完成多步程式任務 | Claude Opus 5.5 | 已提高推理強度仍無法處理的難題,再看 Fable 5.1 |
| 複雜分析、規劃、困難推理,品質比等待更重要 | GPT-6 Astra/Claude Fable 5.1 | 把這一層留給真的需要的工作;固定格式整理不必全走旗艦 |
| Google 工作流,需要一起理解文字、圖片、音訊、影片或 PDF | Gemini 4 Argon | 若需求是大量、較簡單處理,改看 Flash 系列以壓低等待與用量 |
| 讀畫面、操作電腦,或著重自然文字表達 | GPT-6.1 Terra | 工作核心變成較深推理時,再升級;能否操作也取決於工具提供的權限 |
| 大量標籤分類、欄位抽取、簡短格式轉換 | GPT-6 Luna/Claude Haiku 5.5/Gemini 3.5 Flash-Lite | 有多步推理或高風險例外的部分,另交給較強模型 |
這是一份起點很明確的選用表。你已經在 Claude 生態裡,就用 Sonnet/Opus 的分工;已經在 OpenAI 的工具裡,用 Sol/Astra 分工即可,不用為了每張榜的第一名,同時買齊三家。
型號定位來源:OpenAI、Anthropic、Google。
為什麼日常推薦 Sol,而不是一律選最強旗艦?
看查核時 Artificial Analysis 模型榜的四組設定:
| 模型與推理設定 | Intelligence Index v5.0 | 該榜 Cost per Task |
|---|---|---|
| Gemini 4 Carbon(high) | 59 | US$7.76 |
| Claude Opus 5.5(max with fallback) | 58 | US$10.04 |
| GPT-6 Astra(max) | 57 | US$6.24 |
| GPT-6.1 Sol(max) | 55 | US$1.27 |
Sol 在這份快照的分數接近 Astra,評測成本卻差了約 4.9 倍。 這是本文把它放在日常首選的理由:如果工作不需要那一段能力上限,把所有請求都送旗艦,費用很快就會拉開。
這裡的 55 與 57 是綜合指標,不能換算成「只差幾%的智商」;Cost per Task 也是該榜的評測口徑,不是你問一次聊天問題的報價。指標的任務組成與限制,見官方方法。
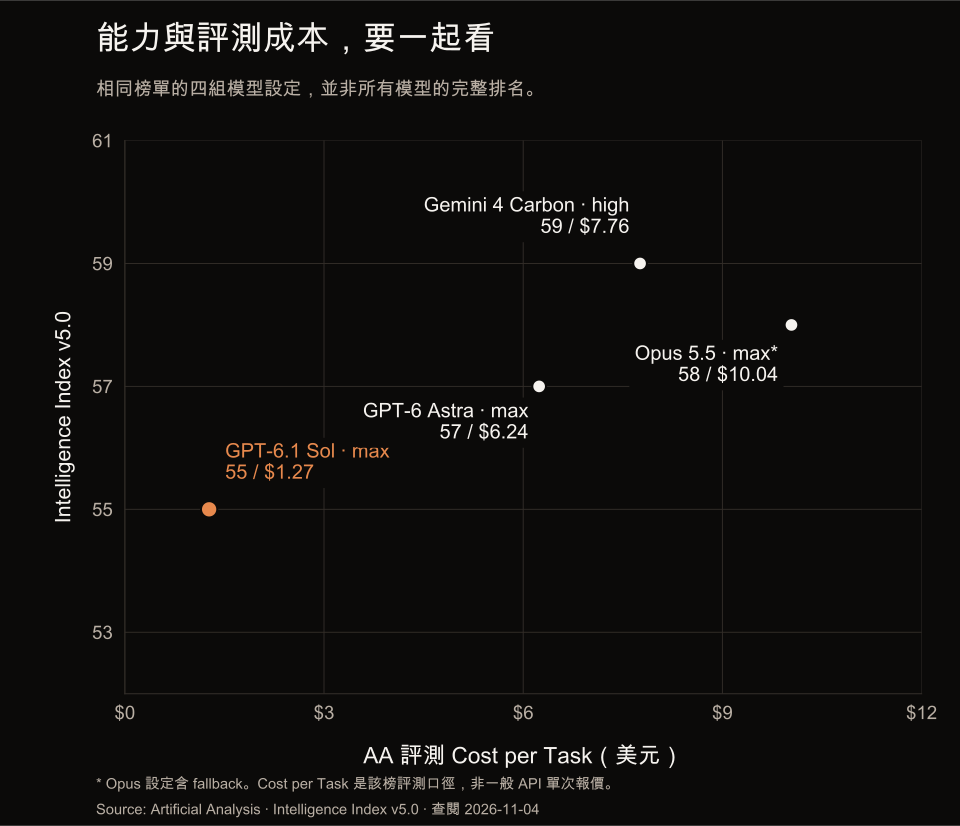
Gemini 4 Carbon 在這份榜單排得很前面,但本文查核的 Google 公開 API 目錄列出的是 Gemini 4 Argon。**不要把榜上的 Carbon 和你選單裡的 Argon 當成同一個型號,**也不要因為看見測試名稱,就預設自己的帳號已能選它。
程式 agent:為什麼我會把 Opus 放在前面?
在查核時的 Terminal-Bench 4.0快照中,Opus 5.5 max 搭配 Claude Code 的任務解決率為 64.8% ± 3.1%;GPT-6.1 Sol max 搭配 Codex 為 58.2% ± 3.1%。 這提供了一個具體理由:若你的主要工作就是讓 agent 長時間操作終端機、修改程式,可以優先考慮 Opus 與 Claude Code 這組搭配。
但這是兩組「模型+agent」的結果,並沒有把所有因素固定成只換模型。它也不直接回答 UI 美感、中文語氣或你的特殊程式庫哪個較好。這段推薦有一個清楚範圍:接近該評測的多步程式與終端機任務。
Fable 5.1 則是 Anthropic 另外列出的高難推理、長程 agent 候選。官方建議在 Opus 提高 effort 仍不足時考慮它。因此日常使用 Claude,我不會從最貴的 Fable 開始;一般工作 Sonnet,較難的 agent 工作 Opus,再往上才是 Fable。 官方模型總覽
API 價格差多少?先把「單價」和「訂閱」分開
下表是查核時官方頁面的列示價格,單位均為 每 100 萬 tokens、美元。OpenAI 使用價目表 Standard/Short 視圖,Claude 使用模型總覽列示價格;快取、長上下文、工具和其他服務等費用條件,請點來源查看。
| 模型 | 輸入 | 輸出 |
|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 |
| GPT-6.1 Terra | $1 | $5 |
| GPT-6.1 Sol | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Sonnet 5.5 | $2 | $10 |
| Claude Opus 5.5 | $4 | $20 |
| Claude Fable 5.1 | $10 | $50 |
來源:OpenAI API 價目表、Claude 模型價格。
拿同一家做一個簡單算例:假設一次工作實際計費為 1,000 個輸入與 1,000 個輸出 tokens,按上表算,Sol 是 US$0.012,Astra 是 US$0.06。這只示範固定 token 數量的單價差,尚未計入額外推理 tokens、工具呼叫或重試。
如果你買的是聊天或 coding agent 訂閱,不能直接把這張 API 價格表當成訂閱額度表。工具可能採用自己的用量池、倍率或額外計費;反過來,付了月費也不一定包含自己用 API 的費用。
寫中文、做研究、看影片,各怎麼選?
中文文案與產品說明:Sol 起步,重視自然表達也可選 Terra
這兩個都可以列為日常文字入口。Terra 的官方定位特別包含自然寫作與視覺推理;如果你同時常拿截圖改介面,這個組合更有理由。**單靠綜合英文榜,不足以宣布哪一個最懂台灣中文,**所以這裡的推薦來自用途定位與費用,而不是捏造一張中文冠軍榜。OpenAI 模型定位
網路研究:選有搜尋與來源能力的入口,再談模型
你要的是最新費率、產品政策或今天的公告時,先確定工具能查網頁、打開來源與附引用。把同一題改丟更貴的離線模型,不能替它補上今天才發布的資訊。研究工具的搜尋、來源讀取與文件處理能力,和模型本身的推理能力要一起看。
影音與長文件管線:Google 使用者先看 Gemini 4 Argon
Google 官方列出的 Argon 輸入包含文字、圖片、音訊、影片與 PDF。如果你正在把這些素材接進同一條工作流程,它是很自然的候選。大量、較簡單的處理可以改看 Flash 系列;不要因為都叫 Gemini,就把 Argon、Flash 與 Flash-Lite 當成同一級產品。 Google 模型目錄
自架與開放權重:已有部署需求,再考慮 Qwen 等模型
例如 Qwen3.5-9B提供權重、Apache 2.0 授權標示與部署說明,適合需要控制執行環境、已有硬體或維運安排的情況。如果你只是想每天聊幾個問題,自架通常不是最省事的起點;模型檔能下載,還是會有運算、延遲和維護成本。
high、max 該怎麼開?
日常改文案、抽欄位、做小修改,用預設或較低推理強度;多個條件互相牽制、需要長程分析時,再提高。 不同廠商的 high、max 不是同一把尺,排行榜有寫設定,閱讀推薦時就把它一起帶著看。
一個例子:上面的 Sol max 55 分,不能保證你在某個產品的 Auto 模式也得到相同配置。長上下文規格同樣如此,「放得進一百萬 tokens」和「能從整份資料找對答案」是不同的能力,不能只照視窗大小買單。
只想留一套付費工具,怎麼搭最簡單?
OpenAI 使用者以 Sol 為主、Astra 處理少數難題;Claude 使用者以 Sonnet 或 Opus 為主,Fable 留給更難的工作。 已經在 Google 工具裡,就從 Argon/Flash 的分工開始。你的需求是大量簡單請求,再往 Luna、Haiku、Flash-Lite 這層走。
這樣選的好處很直接:知道什麼情況該升級,也知道什麼情況可以省下來。想看本文引用的榜單各自在測什麼,接著讀模型排行榜指南;工具還沒選好,先看 Agent 工具比較。
常見問題
Q: 如果只問目前誰最聰明,答案是誰? 在本文保存的 Artificial Analysis v5.0 四組快照裡,Gemini 4 Carbon high 為 59,Opus 5.5 max with fallback 為 58,Astra max 為 57,Sol max 為 55。這是該綜合指標與設定的比較;實際選用時,本文日常推薦 Sol,長程程式 agent 優先看 Opus,困難推理再看 Astra 或 Fable。
Q: 高價模型是不是任何工作都比較值得? 簡單的分類、抽取和短格式輸出,通常沒有必要全部使用最貴旗艦。價格增加可能同時來自更深推理和更多輸出;本文把高階模型留給複雜推理與較難的長程工作。
Q: 我看到同一個模型,為什麼別人的成績不同? 先看完整版本、推理設定、agent、工具與上下文是否相同。API、聊天產品和 coding agent 的執行條件可能不同,不能只憑顯示名稱視為同一組系統。
資料來源
資料查核於 2026 年 11 月 4 日。本文依官方定位、公開評測與費用提出編輯建議,未宣稱做過所有型號的同場實測;型號採 API/官方名稱,聊天產品與 agent 的可用選項可能不同。