看到有人貼「新模型登頂」,很容易想立刻換過去。點進去才發現,這張榜測的是寫作偏好,你想知道的卻是它能不能把登入頁修好。
只想留一個入口,先收藏 Artificial Analysis:能力、價格、速度可以一起看。 想知道真人比較喜歡哪種回答,再看 Arena;要選能做程式工作的 agent,優先看 Terminal-Bench,修 repo 的 issue 則補看 SWE-bench。
本文查核於 2026 年 11 月 4 日。以下數字是查閱時看到的快照,保留榜單版本、模型設定與資料日期,方便你知道當時比較的是什麼。
先收藏這五個入口
| 入口 | 主要看什麼 | 適合拿來回答的問題 | 讀榜時多看一眼 |
|---|---|---|---|
| Arena,前身常被稱作 LMArena/Chatbot Arena | 真人對兩個回答的偏好比較,也有不同任務分類與調整選項 | 這類回答,使用者通常比較喜歡哪個? | 分類、票數、Rank Spread、風格與事實性調整 |
| Artificial Analysis | 綜合能力指標,以及價格、速度、延遲等資料 | 有哪些候選能在能力、等待與成本間比較? | 指標版本、模型推理設定、評測成本的定義 |
| Terminal-Bench | agent 在終端機環境完成工作的結果 | 這組模型與 agent,完成工具操作任務的表現如何? | benchmark 版本、agent 名稱、預算與誤差範圍 |
| SWE-bench | 根據真實軟體 repo 的 issue 進行修改與驗證 | 這組系統在特定修 bug 題集上能解決多少? | Verified/Lite 等題集、agent、設定、提交日期 |
| LiveBench | 依版本提供不同任務與能力評測 | 模型在我關心的任務分類中表現如何? | 目前版本、子項目、評分方式與成本欄位 |
這幾個入口的分數不能直接互換。Arena 的 1500 分、某個綜合指標的 59 分、修復率的 60%,分別有自己的題目和計算方式。
Arena:先理解「大家比較喜歡」的意思
Arena 官方說明,它把真人在成對回答中做出的選擇彙整成排名。常見欄位包含票數、分數的信賴區間,以及可能名次範圍 Rank Spread。來源:Arena 讀榜說明
查閱時,Text Arena Overall頁面標示資料日期為 2026 年 10 月 28 日,可見以下快照:
| 模型與設定 | 畫面順位 | 分數與區間 |
|---|---|---|
| Gemini 4 Carbon(High) | 1 | 1528 ± 9 |
| Gemini 4 Argon(High) | 2 | 1520 ± 6 |
| Claude Opus 5.5(High) | 3 | 1509 ± 7 |
先看分類,再看分數與區間。 要寫繁體中文,就找中文等相近分類,再用自己的文章試;想評估程式工作,也要分清楚文字回答裡的 Coding 分類,和真正執行程式、操作工具的評測。
榜單還有風格與事實性相關選項。你可以觀察調整後的結果,而不是把一次「比較喜歡這份回答」,直接解讀成每個細節都正確。模型之間的區間接近時,也先別把一兩名的落差看得太重。
Artificial Analysis:把能力與成本放在一起
查核時的 Intelligence Index v5.0 方法,把九項評測彙整到知識工作、程式、科學與一般能力四類。官方也說明,這個指標主要是文字、英文評測,其他語言與模態要另外看。
所以它很適合縮小候選,但 不能把綜合分數直接當成「繁體中文比較好」或「所有工作都會贏」。
查閱時的模型榜單可見:
| 模型與榜上完整設定 | Intelligence Index |
|---|---|
| Gemini 4 Carbon(high) | 59 |
| Claude Opus 5.5(max with fallback) | 58 |
| GPT-6 Astra(max) | 57 |
| GPT-6.1 Sol(max) | 55 |
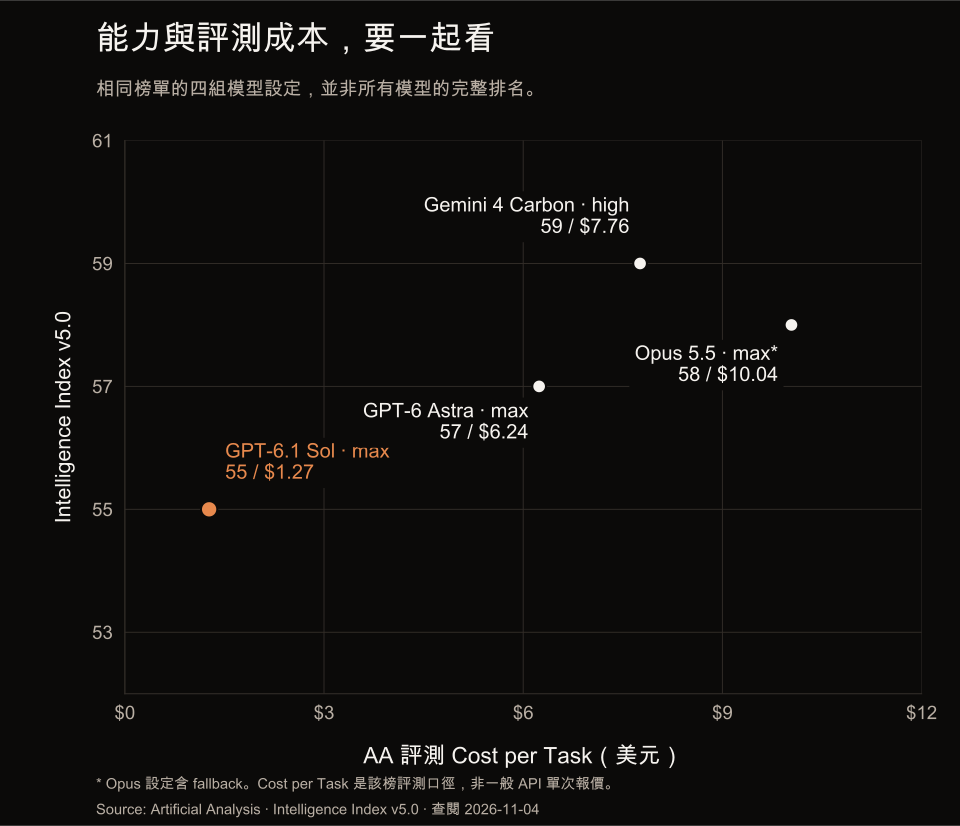
這張表比較的是列出的設定。同一型號的 high、max,或帶 fallback 的配置,要當成不同的測試條件記錄。 你在某個 app 裡選到的 Auto,也未必就是榜上的配置。
接著切去看成本、延遲和整體等待時間。有些工作需要盡快看到第一個字,有些必須等完整檔案做好才有價值,這兩種等待感不一樣。使用 Cost per Task 前,先看網站怎麼定義測試任務與成本;不能直接拿它當成你每次請求的報價。
程式工作:同時看模型和 agent
在 Terminal-Bench 4.0的查閱快照裡,表格把 Model 與 Agent 分成兩欄。例如:
| 模型設定 | Agent | Resolution rate |
|---|---|---|
| Opus 5.5(max) | Claude Code | 64.8% ± 3.1% |
| GPT-6.1 Sol(max) | Codex | 58.2% ± 3.1% |
這是整組系統在該評測下的結果。要判斷差異來自模型還是執行工具,需要更受控制的比較;不能只截掉 Agent 那欄,當成純模型能力排名。
SWE-bench 官方網站則能切換不同題集。查閱時,Verified 說明是經人工篩選的 500 個實例,預設可見 Bash Only、mini-SWE-agent 設定。看「解決率」時,先對齊題集、agent 與版本,再比較提交結果。
模型沒出現在某張表,不等於比較差。 可能尚未有對應的提交;日期較舊的表,也未必包含你現在想選的型號。
LiveBench:別把舊版介紹套在新版上
查核時,LiveBench 官方頁面已是 2.0,最新 release 標示 2026 年 10 月 25 日。頁面介紹的工作包含簡報、研究報告、bug 修復與長時間 app 任務,也列出 Agentic、Design、Coding、Browser Use、Data Analysis、Research、Reasoning 等分類。
這時看單一 Overall,還不如先打開你要做的那一欄。文章或截圖寫「LiveBench 幾分」,至少也要留下版本與分類。 用舊版的印象理解新版榜單,很容易比較錯東西。
七個讀榜時最值得檢查的小地方
- 完整模型名稱一樣嗎? 有沒有日期版本、preview、量化或推理設定的差別?
- 測的工作接近嗎? 中文文案、數學題、修 repo、操作瀏覽器,驗收方式不同。
- 工具環境一樣嗎? 有沒有搜尋、程式執行、檔案、不同 agent 或人工協助?
- 版本與資料日期一樣嗎? 題目和評分方式更新後,數字可能無法直接串成進步曲線。
- 測了幾次、容許重試嗎? 一次就成功,和多試幾次選最好的一次,要分開看。
- 差距有多確定? 看樣本、區間與方法,別只看大字名次。
- 你實際用得到嗎? 帳號是否可選、能不能部署、等待與用量是否在預算內?
還有一個容易漏掉的地方:兩張榜可能使用相同的底層評測。 例如查核時的 Artificial Analysis v5.0 已包含 Terminal-Bench 4.0;兩邊結果都好,可以當作線索,但別當成兩份完全獨立的證據。
如果只想快速找到答案,該開哪張榜?
| 你想知道的事 | 直接去哪看 | 先看哪個欄位 |
|---|---|---|
| 綜合能力比較高、又不想花太多錢 | Artificial Analysis | Intelligence、Cost per Task、完整推理設定 |
| 中文回答、寫作與語氣比較討喜 | Arena 的相近分類 | 分類、票數、區間,再留意 Style Control 與 Factuality 選項 |
| 一整組 coding agent 能不能完成終端機工作 | Terminal-Bench | Model 和 Agent 兩欄一起看,接著看版本與解決率 |
| 能不能修實際 repo 的 issue | SWE-bench | 題集、agent、% Resolved 與提交日期 |
| 長程工作、研究、設計或瀏覽器等分類 | LiveBench 2.0 | 對應子項目,接著看成本和方法 |
不用把五張總榜的名次平均。 它們的題目與評分方式不同。想花錢買工具時,本文會先用 AA 理解模型的能力與成本,再用 Terminal-Bench 看 coding agent 的整組結果;想知道回答好不好讀,才補看 Arena。
如果你要的是「現在到底選哪個模型」,可以直接讀模型推薦與價格比較。如果你連編輯器、CLI 或雲端工作方式都還沒決定,先看 Agent 工具推薦。
常見問題
Q: LMArena 和 Arena 是不同的網站嗎? 目前 Arena 的 Text 榜頁面說明,它的前身常被稱作 LMArena 與 Chatbot Arena。查資料時,可以從目前的 Arena 官方入口確認榜單與方法。
Q: 要寫程式,只看 SWE-bench 就夠了嗎? SWE-bench 適合看特定 repo issue 修復結果。要選會連續操作終端機的 coding agent,Terminal-Bench 更接近這類問題;要判斷中文表達或介面設計,則要看其他分類。
Q: 有沒有一張永遠準的總榜? 很難用單一排名涵蓋所有工作。先挑和需求接近的分類,確認測試條件,再比較實際結果。你要找的是適合自己工作、能穩定驗收的選擇。
一手來源與快照說明
- Arena:Text leaderboard、官方讀榜說明。本文 Text 快照的頁面資料日期為 2026 年 10 月 28 日。
- Artificial Analysis:Models leaderboard、Intelligence Index 方法。本文記錄查閱時的 v5.0 與所列推理設定。
- Terminal-Bench 官方網站。本文使用查閱時的 4.0 表格,保留 agent 欄位與區間。
- SWE-bench 官方網站。引用其題集與預設設定說明,未把不同配置混成一個排名。
- LiveBench 官方網站。本文引用 2.0、release 日期 2026 年 10 月 25 日的頁面說明。
所有入口查閱日期均為 2026 年 11 月 4 日。之後讀到本文時,先點回來源確認最新版本,再把同一套讀榜方法用上去。